【任务6】注册与登录:初步完善注册功能
请打卡如下内容
1、大致说一下你是怎么限制用户昵称重复的
2、给出你敏感词过滤的算法
3、给出你限制密码强度/长度/字符的算法
对于代码的提交,你可以用

这样就可以高亮了
本问题对应的项目链接:从0设计一个web项目
PS:每一个打卡,都要给出你的GitHub链接哈,并且代码提交到GitHub
 shuaidi
请打卡如下内容
1、大致说一下你是怎么限制用户昵称重复的
2、给出你敏感词过滤的算法
3、给出你限制密码强度/长度/字符的算法
对于代码的提交,你可以用
这样就可以高亮了
本问题对应的项目链接:从0设计一个web项目
PS:每一个打卡,都要给出你的GitHub链接哈,并且代码提交到GitHub
共以下 11 个回答
github仓库:https://github.com/CurryisCoat/community/tree/dev
1.在数据库设计表时给用户名字段添加唯一索引;
2:前缀树
github仓库:https://github.com/yijixin66/FromZerotoExpert
服务器:http://8.142.128.17/FromZerotoExpert/register.html
1、 在添加用户名之前查询数据库是否已存在该用户名
2、 AC自动机,在trie树的基础上加入fail指针,类似于kmp中的next数组,可以在匹配失败时跳过已匹配的部分
3、 遍历字符串 在CheckUtils中实现
^(?!\d+$)(?![a-z]+$)(?![A-Z]+$)[\da-zA-z]{6,16}$
GitHub地址:https://github.com/lei342345795/FromZerotoExpert
1、考虑到高并发,采用redis分布锁
2、
3、
github:https://github.com/Egofir/ferry
做接下来两讲之前,我先去看了后面的大佬分享,从中获取了不少思路
1、用户名去重:
上个版本搭建注册的时候已经使用查数据库 + 唯一索引的方式做了去重。
看了文章之后,使用redis实现分布式锁,防止同一个用户名被并发访问,同时每个获取锁的线程还设置了不同的value,防止锁的误解除,并设置了较长的过期时间减少因为执行流程过长而导致的并发执行问题。
但我个人觉得,注册这个功能,在大部分场景下应该不能算一个高并发场景,就算是并发,同一个key被高并发访问的概率也是不大的,不过,造火箭嘛,嘿嘿。
2、给出你敏感词过滤的算法
看了帅地大佬的trie树思路,自己用基于计数的思路写了一个。
封装成trie树类,方便后续复用(除了用于敏感词,还可以用于词频统计等场景)
以下是代码:
3、给出你限制密码强度/长度/字符的算法
本来是想写一个注解来实现这个功能的,发现要是用注解来实现的话,如果想分情况为前端返回非法密码的情况,将要写很多注解,只是为了一个参数校验的话,我觉得是很浪费的,因此还是改为使用工具类实现了,同时借此机会将代码所有的常量和枚举重新整理了一下,密码校验的代码比较简单:
枚举
github地址:https://github.com/lucca-suen/FromZerotoExpert/tree/v2.2
限制用户名重复的话我和
月诉长安同学的思考过程差不多,因为注册是个并发量大的模块,所以最麻烦的就是查询失效的问题,暂时也想不到怎么搞;暂时只用axios弄了个最基本的异步查询出来:就是后端直接返回字符串,然后前端控制显示在指定的位置。
敏感词判断
功能最简;所以不会实际拦截不合要求的请求
看的大家都用的前缀树,我自己也是想的前缀树,所以 项目里面的实现弄一个前缀树实现;
项目里面的代码就用别人的Java代码了,反正实现都差不多
密码强度判断
密码强度的限制的话差不多也是用正则判断,我自己也想不到其他的了 >_<
前端的部分和第一个差不多,所以没做;
密码判断的逻辑在打卡区找了一个正则表达式的,直接参考的他的,所以没写
项目地址: https://github.com/Runninginsilence1/FromZero2Expert/tree/dev
1.实现防止用户重名:
一开始我没想这么多,简单的查询返回。后来在网上论坛看相关的讨论有了以下的理解。主要容易出问题的场景就是“高并发”,为了防止高并发下用户名查询查重速度变慢,查重就会失效。以我现在的水平我只想到了加锁,而且是最简单的在查找逻辑那里加锁,论坛讨论是加分布锁(没听说过),我了解了分布式知道了原因,一般选用Redis实现分布式锁(又是盲区),锁的范围也不能简单粗暴的包括整个方法,要降低锁的粒度。然后就是对Redis实现的详细讨论,我毕竟没学过也没看懂。另一种方式就是将username字段设置成唯一属性,将错误丢给数据库处理,论坛说:
“但唯一约束会严重制约扩展能力(读写分离、分库分表),同时降低系统的健壮性(通过数据库报错来反馈业务错误信息)。除了唯一索引,还可以锁表,但是我觉得任何一个有责任心的程序员都不会这样实现。”
至于为什么会导致这么多问题,我也不太清楚。到此,一个小小的查重,能反映我有多么菜···,这些问题我先标记一下,在以后的学习中,我会解决心里的疑惑。
2.敏感词审查。
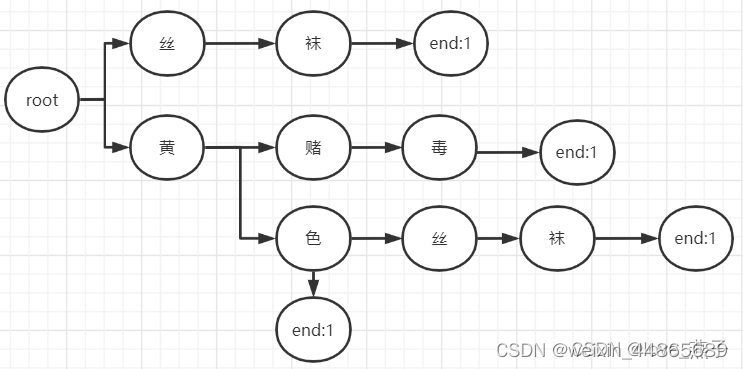
第一步:将敏感词的词库转换成利于敏感词检测的数据结构,我感觉就是转成森林,森林中每一个树都是开头字符相同的一类敏感词,节点是敏感词的单个字符,根结点事敏感词的开头字母。每个节点都有状态表示,endl=1 表示从root节点到此节点一个敏感词结束
第二步:在java中用hashmap来实现这个数据结构:如上图的数据结构可以表示为:
{<丝, {<袜, {<endl, 1>}>, <endl, 1>}>, <end, 0>}
{<黄, {{<色, {<丝, {<袜,{<end,1>}>>, <end, 1>}>, < endl, 0>}>,<endl, 0>},{<赌, {<毒,{<endl, 1>}>,<endl, 1>}>, <endl, 0>}}>, <end, 0>}
第三步:代码实现,我就不放代码了,我尝试实现出很多问题,功力不够,我在网上找的源码,读的他的源码复现的
3.密码格式判断
是的,一个小小的问题,面试就可以谈论很多,不过问题不大,以后就慢慢懂了,后面Redis也学下勒
1.我是首先在数据库的user_name字段上加了个唯一索引,然后在注册账号接口,也就是业务层先查询数据库中是否已存在这个昵称来判断是否执行接下来的操作,既然已经在业务层判断昵称是否重复,我认为还是有必要在数据库中再判断下,因为我认为用户可以通过在前端页面找到后端的注册账号接口,并摸清数据格式,然后向注册接口。。。,好像只需在业务层判断就行,唯一索引没有必要,我认为另外还需对后端接口的参数验证,前端也需验证,前端验证主要是防止普通用户输入错误的参数,而后端对数据进行验证,是放在一些人恶意向接口发送一些错误的数据。
2.敏感词过滤,用前缀树(HashMap实现)实现
注册接口代码:
github地址:https://github.com/shuaishuaixi03/FromZerotoExpert/tree/dev
1、限制用户名重复,在注册接口那里去数据库中查找username,是否有相同的值,然后返回状态码,前端通过Ajax进行接收,显示到界面;


2、敏感词过滤:也是采用前缀树这种数据结构进行过滤的,之前也没学过这个数据结构,就趁这次机会学习了一下,选择前缀树也是因为其利用字符串的公共前缀来降低查询时间,来提高搜索效率。
利用文件IO的知识,将文本文件中的敏感词读取出来,然后存入前缀树的节点中,

然后利用指针来读取节点的值,过滤传入的值是否为敏感词
3、密码长度、强度的限制:使用正则表达式进行匹配
然后在注册接口处使用来限制用户名的输入
GitHub链接:https://github.com/zzxjava/FromZerotoExpert/tree/dev
username_unique(username) 语句A.首先构造Trie类:
ps: 为了简化Controller层,具体判断昵称和密码以及设置其对应的返回结果都在Service层的两个函数isUserName( )和isPassword( )完成, 注意对结果的修改可以通过传入 CommonResp的引用动态修改
服务器链接:http://124.223.184.187:8088/FromZerotoExpert
Github仓库链接:https://github.com/jiangyklala/FromZerotoExpert/tree/dev
我看你用户插入时,是否插入成功,好像没有给个返回值之类的哦。另外就是关于防重复的设计,也可以参考下我总结的方案哦。
我在 Controller 中做了逻辑判断
以下是UserService中两个函数的实现
关于redis,分布式锁目前还没学到?,慢慢补
可以哦,对于还没有学过的,按照最原始的方式来实现就行,以后可以回过头来补滴。
另外就是,你的代码其实我有看了一下,就是对于 userService.addUser(user);,用户在插入的时候,好像没看到插入成功或者失败的代码。比如用户名重复了,唯一字段导致插入失败,你这个时候的返回值是啥啊
本次功能主要是校验信息,如校验用户名(冲突、长度、敏感)以及校验密码(长度、强度、字符),因此在建立校验算法之前,先提前构建一个RegisterResult类来返回校验结果,供前端接收统一处理,其中RegisterResult类包含两个属性,isQualified属性(布尔类型,代表校验成功/失败)和message属性(String类型,返回失败时的信息,如“用户名含有敏感词”)。
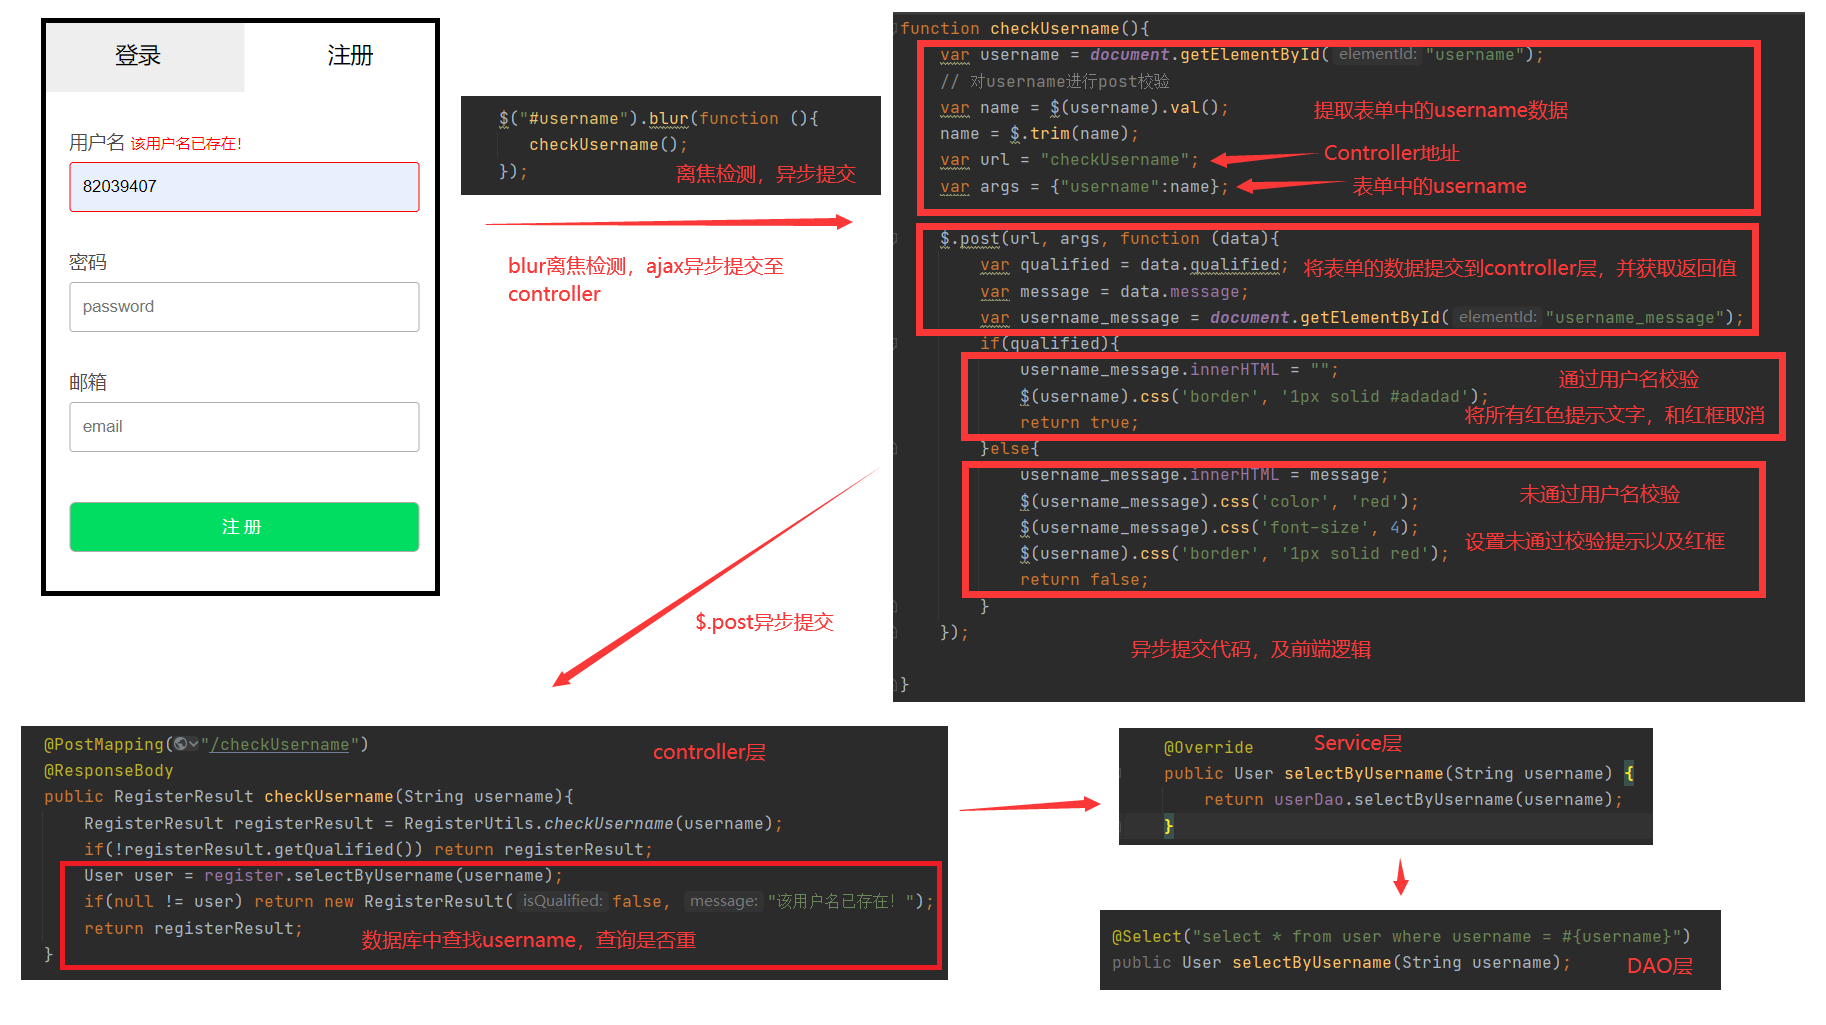
1.用户名重复校验
在username输入框中进行离焦检测(blur),当离焦时,用ajax异步提交到controller中的usernameCheck()方法进行检测,检测重复的算法也很简单,就是在数据库中查询username,看看是否能返回User对象,若返回为null则数据库中没有重复的用户名,否则用户名重复,让前端页面给出提示。注:用户名重复的检测需要提交到数据库速度可能会慢一些,所以应该先对用户名的长度、敏感词进行检测,若不符合,就不用提交到数据库进行查重检测了,若长度和敏感词全都符合要求,则再进行查重处理,可能这样就会节省一点时间。(自己想的,不知道对还是错)。
2.敏感词校验
首先写前缀树的代码,因为之前leetcode编写过这道题,所以能直接写出代码,然后构建一个记录敏感词的数组,这里是在工具类中定义的一个静态成员数组sensitiveWords,有点写死了,然后建立前缀树对象并将敏感词插入,然后将用户名传入进行检测,具体方式为逐个字符判断后续子串是否为敏感词的前缀,若不是,则不可能为敏感词,进行下一个字符的检测。若是,则加长子串,检测直至前缀为敏感词且子串为敏感词时,则该用户名包含敏感词。
注:这里其实用帅地哥分享的p1,p2,p3三个指针遍历前缀树检测时间复杂度会少一些,但是我想着用户名长度一共也就15,就没太在意复杂度了,就写的有点暴力,这里后面可以优化的。
3.密码校验
这个算法还是挺简单的,具体如图所示在这里不进行过多的介绍了。
gitHub路径:https://github.com/Second6s9/FromZerotoExpert/tree/dev
gitHub防覆盖路径:https://github.com/Second6s9/FromZerotoExpert/tree/day06
服务器地址:http://39.101.66.57:8080/FromZerotoExpert/register
实际上 ,关于 用户名 重复,是一类实际项目中非常 常见的问题,归属「防重」这一类问题,针对这个问题,在面试可能面试官就会和你谈 造火箭的。
我先抛一些问题给你,后面我会给出解决方案。
1、比如通过查询数据库判断重复,那高并发下怎么办?这样会出现重复
2、有人可能会说,我可以用唯一字段约束,这确实是最省事的,但是我们不应该把问题抛给数据库去处理,应该是业务层处理,而且用了唯一约束,其实会影响后续的拓展,毕竟改表操作是一个很危险的操作。
3、有人可能会说,我可以用 sychronized 加锁的,但是sychronized 只能锁单机,而且我们还得保证锁的力度尽量小。
4、好吧,我 用分布式锁吧,那用啥作为分布式锁?最简单的就是 redis,但是redis有很多抗,可能面试官还会让你手写一个。
5、好吧,用redis来分布式锁,那 key 应该是什么呢?怎么设置key才更加高效呢?
……
这些,都能 成为连环炮,当然,我们不求最优解,只求 思考过,给出面试官一个合理的答复。
不过这些,我会慢一点讲吧,主要好多人没跟上。
谢谢帅地哥提供的思路,首先,坦率的讲,我在完成这个任务的时候完全没有考虑到高并发情况的,如果在真正业务中存在高并发需求的话,以我目前的思路,只能想到用唯一字段或使用sychronized加锁的方式去解决,但这两种方法貌似都并不是好的解决方案。并且对于redis以及分布式锁,我只是在别人的项目中看到过,或是自己简单的拿来套用一下,理解的层面并不是很深入,只能说是能看懂别人是怎么实现的,自己实现则完全没有思路,于是我就自己简单的查了一下「防重」问题的解决方案,整理的思路如下:
1.给表设置唯一索引
这样做的好处是简单粗暴成本低,但是会有一些缺点,就是我们很多的业务表中数据的删除操作一般并不是物理删除,而是逻辑删除操作(设置删除状态码),对于这样的表,设置唯一索引可能会带来一些坏处,比如当我们进行了逻辑删除操作时,我们只是将删除状态码进行了改变,但数据依然存在,可是当我们要插入这个已经删除了的数据时,会发生冲突(因为还在表中,只是改变了状态码),所以这种情况设置唯一索引是不可行的。
2.redis分布式锁
基本原理是在数据库执行添加操作前,进行加锁,如果加锁成功,则检测是否重复,若不重复则进行添加。分布式锁的目的主要是保证了查询操作和添加操作的原子性,但是这种方式也是有一些弊端的,比如当面临大量的数据添加时,每一次的添加操作都需要加锁才能完成,这将大大影响性能,很明显,分布式锁只适用于少量的添加操作,对于批量接口,加redis分布式锁,不是一个理想的方案。
3.防重表
对于1中的方案,在逻辑删除的表中不可行,而2中的方案在面临大量的添加操作时,性能方面也会存在问题,因此可以换一种思路,就是构建一张防重表,表中的数据记录了需要查重的字段,并设置为唯一字段,当进行添加操作时,先在防重表中添加数据,如果添加成功,则说明没有重复,否则说明数据重复,可以通过异常捕获进行处理。并且当原表进行逻辑删除操作时,将防重表进行物理删除,这样就解决了之前的问题。
以上是我查到的一些思路,说实话,受益匪浅,自己在做项目的时候完全想不到这么多,并且在查的过程中还了解到了一些如何在高并发情况下保证接口幂等性的相关解决方案,真的是越深入了解,越发现自己不懂的还是太多。总之,路漫漫其修远兮,还需要加倍努力的呀!
没有考虑正常的,做的时候也不用去高并发做,我就等大家做完跟大家说一说 造火箭 勒,基于面试喜欢造火箭的方式来。
另外就是,对于redis分布式锁,有个可以优化的方案,每次加锁时 Key 都设置成不一样的,就可以增加效率了,因为只有 用户名 相同时,才需要获取锁,我们的 key 可以用 前缀 + 用户标识 的方式,这样效率就会很高的,基本不用等待锁,因为重复名的还是很少的。
但是这样会有一个问题,就会有大量 key,对于这种情况,我们可以想个策略删除他们,比如用户插入成功后,就删除这个key。